
ATPIA | 2026. 8. 29. | 기술개발·서비스 소식
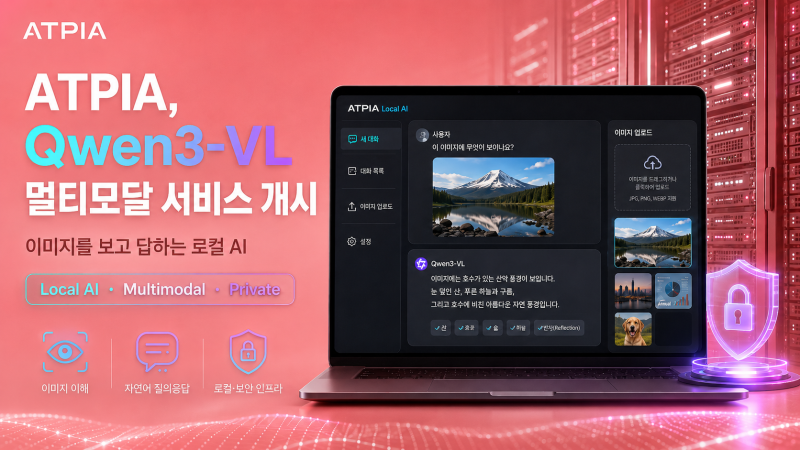
ATPIA가 기존 Qwen3 텍스트 전용 로컬 LLM 서비스에 이어 이미지와 텍스트를 함께 이해하는 Qwen3-VL 멀티모달 AI 웹서비스를 개시한다. 사용자는 브라우저에서 사진·스크린샷 등을 첨부한 뒤 이미지 내용에 대해 질문하거나 분석을 요청할 수 있다. 서비스는 https://atpia.com/qwen3-vl/index.html 에서 제공되며, 개발 소스코드는 GitHub에 공개됐다.
텍스트에서 이미지까지… Qwen3 서비스의 다음 단계
ATPIA가 이번에 선보이는 Qwen3-VL 서비스는 앞서 구축한 qwen3:8b 텍스트 전용 채팅 서비스를 멀티모달로 확장한 버전이다. 기존 Qwen3가 사용자의 문자 입력을 받아 답변하는 데 초점을 맞췄다면, Qwen3-VL은 텍스트와 이미지를 한 대화 안에서 함께 처리한다.
개발보고서에 따르면 사용 모델은 Ollama에서 구동하는 qwen3-vl:8b 비전-언어 모델(VLM)이다. 브라우저에서 이미지를 첨부하면 클라이언트가 이미지를 base64로 인코딩해 메시지와 함께 전송하고, FastAPI 백엔드가 이를 검증한 뒤 로컬 Ollama API에 전달한다. 모델의 추론 결과는 SSE(Server-Sent Events) 방식으로 브라우저에 실시간 스트리밍된다.
핵심은 외부 클라우드 AI API를 호출하지 않는다는 점이다. 모든 추론은 ATPIA의 로컬 PC와 GPU에서 이뤄진다. 개발 환경에는 NVIDIA GTX 1070 8GB가 사용됐다. 따라서 이번 프로젝트는 멀티모달 모델을 자체 장비에서 실제 웹서비스로 연결하는 전 과정을 직접 구현했다는 데 의미가 있다.
Qwen3 8B와 Qwen3-VL 8B, 무엇이 달라졌나
항목 | 기존 qwen3:8b | qwen3-vl:8b |
|---|---|---|
입력 | 텍스트 전용 | 텍스트 + 이미지 |
서비스 포트 | 8000 | 8001 |
서비스 경로 | /qwen/ | /qwen3-vl/ |
이미지 입력 | 없음 | messages[].images (base64 배열) |
요청 타임아웃 | 60초 | 180초 |
사진 첨부는 버튼·드래그·Ctrl+V… 사용성을 웹브라우저 안에
Qwen3-VL의 프론트엔드는 React 같은 별도 프레임워크 없이 HTML5와 Vanilla JavaScript만으로 구성됐다. 단일 HTML 파일 안에 채팅 UI와 이미지 첨부, 미리보기, 스트리밍 처리 등 필요한 기능을 담아 구조를 단순화했다.
이미지를 넣는 방법도 세 가지다. 사용자는 첨부 버튼을 눌러 파일을 선택하거나, 이미지를 텍스트 입력창 위로 끌어다 놓을 수 있다. 화면 캡처 뒤 Ctrl+V로 클립보드 이미지를 바로 붙여넣는 것도 가능하다. 전송 전에는 썸네일을 확인하고 개별 이미지를 삭제할 수 있으며, 대화창에 표시된 이미지는 클릭해 확대할 수 있다.
한 번의 요청에는 최대 4장의 이미지를 첨부할 수 있고, 이미지 한 장의 최대 크기는 10MB로 제한했다. 이 검증은 클라이언트와 서버 양쪽에서 수행된다. 특히 서버는 업로드 이미지를 디스크에 저장하지 않고 메모리에서만 처리하도록 설계했다. 브라우저에서 붙는 data:image/jpeg;base64 같은 data URI 접두사는 백엔드에서 제거한 뒤 Ollama가 받을 수 있는 순수 base64 데이터로 변환한다.
멀티모달 서비스에 사용된 주요 기술
영역 | 적용 기술 | 역할 |
|---|---|---|
AI 추론 | Ollama + qwen3-vl:8b | 로컬 GPU에서 텍스트·이미지 멀티모달 추론 |
백엔드 | Python 3.11, FastAPI, httpx, uvicorn | 채팅 API, 이미지 검증, Ollama 스트리밍 중계 |
프론트엔드 | HTML5 + Vanilla JS | 이미지 업로드·미리보기·채팅 UI |
통신 | REST API + SSE | 생성되는 응답을 브라우저에 실시간 전달 |
이미지 전달 | base64 + JSON | 브라우저 이미지를 메시지와 함께 전송 |
웹 인프라 | Ubuntu + Apache | HTTPS 진입점과 리버스 프록시 |
운영 | systemd | 부팅 자동시작·장애 시 자동 재시작 |
GPU | NVIDIA GTX 1070 8GB | 로컬 모델 추론 |
이미지 분석 응답도 “한 글자씩” 실시간으로
멀티모달이라고 해서 응답이 모두 생성될 때까지 기다리도록 만들지는 않았다. FastAPI는 httpx.AsyncClient의 stream() 기능으로 Ollama의 응답을 비동기로 받아 SSE로 브라우저에 전달한다. Apache 리버스 프록시에는 flushpackets=on을 적용해 중간 버퍼링을 줄였고, 모델 응답 시간이 길어질 수 있다는 점을 고려해 프록시 타임아웃을 185초, 애플리케이션 요청 타임아웃을 180초로 맞췄다.
Qwen 계열 모델에서 나타나는 <think> 블록은 자동 감지해 접고 펼칠 수 있는 “생각 중…” 영역으로 처리했다. 스트리밍 중에는 커서 애니메이션을 표시하며, Enter는 전송, Shift+Enter는 줄바꿈으로 동작한다. 외부에서 서브패스(/qwen3-vl/)로 서비스하더라도 API 경로가 깨지지 않도록 배포 위치를 자동 감지하는 로직도 넣었다.
Apache·systemd까지 연결… “모델 데모”가 아니라 운영 서비스로
ATPIA는 웹브라우저의 HTTPS 요청을 Apache가 받아 내부 127.0.0.1:8001의 FastAPI로 전달하고, FastAPI가 다시 로컬 11434 포트의 Ollama에 요청하는 구조를 사용한다. 외부에서 모델 런타임을 직접 호출하는 대신 웹서버와 애플리케이션 계층을 거치도록 구성한 것이다.
배포 과정에서는 이미지 base64 인코딩에 따른 요청 크기 증가를 고려해 Apache의 LimitRequestBody를 약 15MB로 설정했다. 운영 프로세스는 systemd가 관리한다. 네트워크가 완전히 올라온 뒤 서비스를 시작하고, Ollama 서비스의 선행 기동을 보장하며, 환경변수는 systemd 파일 안에 직접 쓰는 대신 별도 .env 파일로 분리했다. 서비스가 종료될 경우 자동 재시작하도록 구성했고 실제 리부팅 뒤 자동 시작도 확인했다.
2026년 5월 일주일간 구축… 소스코드까지 GitHub 공개
개발보고서에 기록된 개발 기간은 2026년 5월 5일부터 5월 11일까지다. 이 기간 동안 qwen3-vl:8b 모델 연동, 멀티모달 메시지 구조, 이미지 검증과 메모리 처리, SSE 스트리밍, 브라우저 UI, Apache 리버스 프록시, systemd 자동 기동까지 구현했다.
개발이 완료된 뒤 소스코드는 GitHub 공개 저장소로 정리했다. 실제 서버 설정을 담은 .env 파일은 .gitignore로 제외하고, 사용자가 구조를 이해할 수 있도록 .env.example을 제공했다. Dockerfile, docker-compose.yml, Apache 설정 예시, systemd 서비스 파일, 한국어·영문 README 및 개발보고서도 함께 공개했다. 개발 과정에서 상위 디렉터리가 잘못 git 루트로 잡히는 문제도 프로젝트 디렉터리 내부에서 저장소를 다시 초기화하는 방식으로 해결했다.
ATPIA가 확보한 다음 기반은 ‘보는 AI’
기존 Qwen3 로컬 LLM 구축을 통해 ATPIA가 자체 서버에서 텍스트 생성 AI를 운영하는 경험을 확보했다면, Qwen3-VL은 그 범위를 이미지 이해까지 넓힌다. 사진·스크린샷·문서 이미지 등 시각 입력을 함께 처리할 수 있게 되면서 향후 OCR, 문서 분석, 이미지 기반 질의응답, 현장 사진 판독 등 다양한 업무형 AI 서비스로 확장할 수 있는 기반이 마련됐다.
이번 개발보고서에는 별도의 정확도, 처리속도, 동시접속자 수 벤치마크는 제시돼 있지 않다. 따라서 현재 단계의 의미는 상용 성능을 과장하는 데 있기보다, 오픈소스 비전-언어 모델을 외부 API 비용 없이 로컬 GPU 한 장에서 구동하고 이를 실제 웹서비스로 배포·운영하는 엔드투엔드 기술을 직접 구현했다는 데 있다.
서비스 이용 및 소스코드
Qwen3-VL 서비스
https://atpia.com/qwen3-vl/index.html
AI 모델
qwen3-vl:8b (Ollama 로컬 구동)
소스코드
https://github.com/handuru01/qwen3-vl
서비스 특징
텍스트 + 이미지 멀티모달 대화 / 외부 클라우드 API 미사용