
ATPIA | 2026. 8. 29. | 기술개발·서비스 소식
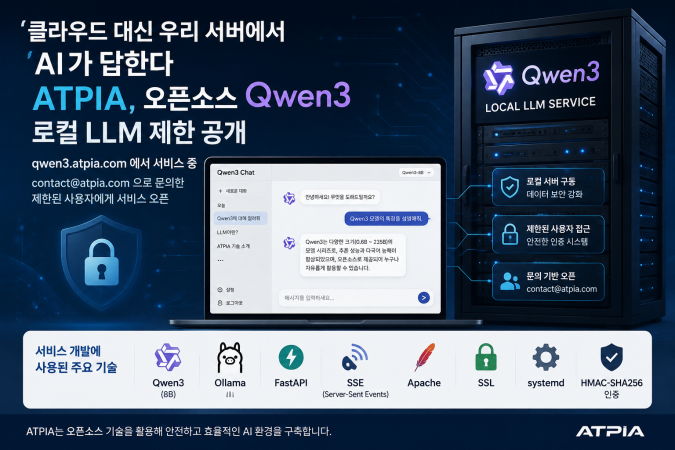
ATPIA가 오픈소스 대규모언어모델(LLM) Qwen3를 자체 로컬 서버에 설치하고, 브라우저에서 바로 대화할 수 있는 웹서비스를 구축했다. 외부 상용 AI API에 전적으로 의존하지 않고 자체 GPU에서 모델을 구동하는 구조다. 현재 서비스는 qwen3.atpia.com에서 운영 중이며, 초기 단계에서는 contact@atpia.com으로 이용을 문의한 제한된 사용자에게 접근 권한을 제공한다. |
ATPIA는 이번 프로젝트를 통해 오픈소스 LLM을 단순히 설치하는 수준을 넘어, 모델 구동부터 웹 인터페이스, 실시간 응답 전송, 사용자 인증, HTTPS, 서비스 자동 재시작까지 실제 운영에 필요한 구성요소를 하나의 서비스로 묶었다. 개발보고서에 따르면 이 서비스는 Ubuntu 기반 개인 서버에서 NVIDIA GPU를 이용해 Qwen3 모델을 추론하고, Ollama와 FastAPI가 모델과 웹 사용자를 연결하는 방식으로 동작한다.
오픈소스 Qwen3를 ‘내 서버의 AI’로
이번 서비스에 탑재된 모델은 qwen3:8b이며, GGUF Q4_K_M 양자화 버전(약 5.2GB)을 Ollama 런타임에서 구동한다. 개발보고서의 서버 구성은 NVIDIA GTX 1070 8GB GPU를 사용한다. 대규모 상용 클라우드 인프라가 아니라 비교적 제한된 하드웨어에서도 오픈소스 LLM을 실제 웹서비스로 연결해 운영할 수 있도록 구성한 것이 특징이다.
프로젝트의 출발점은 분명했다. “클라우드 API 비용 없이 로컬 GPU로 LLM 서비스를 제공한다”는 목표다. 이를 위해 모델 추론은 로컬 Ollama가 맡고, 사용자 요청과 응답은 자체 백엔드가 중계한다. 결과적으로 ATPIA가 서버와 서비스 흐름을 직접 통제할 수 있는 독립적인 AI 서비스 기반을 마련했다.
서비스 구조 한눈에 보기
구성요소 | 적용 기술 | 역할 |
|---|---|---|
AI 모델 | Qwen3 8B (Q4_K_M) | 자연어 생성·추론 |
모델 런타임 | Ollama | 로컬 모델 로드 및 추론 API |
백엔드 | FastAPI + Python 3.11 | REST API·SSE 스트리밍·인증 |
비동기 통신 | httpx | Ollama 스트리밍 응답 중계 |
웹 UI | HTML/CSS + Vanilla JavaScript | 로그인·멀티턴 채팅·실시간 출력 |
웹 인프라 | Apache 2.4 + Let’s Encrypt | 리버스 프록시·HTTPS |
운영 | uvicorn + systemd | 프로세스 실행·자동 재시작 |
토큰이 생성되는 즉시 화면에… SSE로 구현한 실시간 대화
웹 채팅의 체감 품질을 좌우하는 핵심 기능은 SSE(Server-Sent Events) 스트리밍이다. 사용자가 질문을 보내면 FastAPI가 Ollama의 스트리밍 응답을 비동기로 받아 SSE 형식으로 변환하고, Apache가 버퍼링하지 않고 브라우저로 즉시 전달한다. 답변 전체가 끝날 때까지 기다리는 대신 생성되는 토큰이 순차적으로 화면에 나타나는 구조다.
프론트엔드는 별도의 무거운 프레임워크 없이 단일 HTML 중심으로 구성했다. 스트리밍과 비스트리밍 모드를 선택할 수 있고, 여러 차례 이어지는 대화를 위한 멀티턴 히스토리를 브라우저에서 관리한다. Qwen 계열 모델에서 나타날 수 있는 <think> 블록은 접고 펼칠 수 있도록 처리했으며, 스트리밍 중에는 타이핑 커서를 표시해 응답 진행 상태를 보여준다.
404 오류부터 SSL·systemd까지… “서비스가 되는 AI”를 만드는 과정
개발은 2026년 5월 2일 기본 채팅 API와 HTML UI를 만드는 것으로 시작됐다. 같은 날 SSE 스트리밍과 사고과정 블록 표시, Docker 및 Compose 설정을 추가했다. 이후 외부 접속 과정에서 API 경로가 잘못 연결되며 발생한 404 오류를 해결하기 위해 배포 위치를 자동 감지하는 로직을 넣고 Apache 리버스 프록시를 정비했다.
6월 14일 서비스 점검에서는 systemd의 203/EXEC 오류를 추적해 uvicorn 실행경로와 사용자 권한 문제를 바로잡았다. 또한 qwen3.atpia.com 전용 VirtualHost를 구성하고, SSL 인증서가 없는 상태에서는 Apache가 정상 기동되지 않아 certbot을 실행하기 어려운 이른바 ‘닭-달걀’ 문제를 HTTP 임시 설정 → 인증서 발급 → HTTPS 전환 순서로 해결했다.
주요 개발 이력
시점 | 단계 | 주요 내용 |
|---|---|---|
2026. 5. 2. | 초기 구현 | 채팅 API·기본 UI, SSE 스트리밍, <think> UI, Docker/Compose |
2026. 5. 3. | 외부 연동 | Apache reverse proxy, API 경로 자동 감지, systemd 구성 |
2026. 6. 14. | 운영 안정화 | systemd 오류 해결, HMAC 인증, 전용 서브도메인·SSL 구성 |
2026. 8. | 제한 공개 | qwen3.atpia.com 운영, 문의 기반 제한 사용자 서비스 |
제한 공개를 위한 인증… HMAC-SHA256 토큰 적용
현재 Qwen3 서비스는 완전한 불특정 다수 공개가 아니라 제한된 사용자를 위한 초기 서비스 형태다. 백엔드는 로그인 시 비밀번호를 검증한 뒤 HMAC-SHA256 기반 Bearer 토큰을 발급하며, 이후 상태 확인과 채팅 API는 인증된 요청만 처리한다. 서버가 재시작되면 기존 토큰을 다시 사용할 수 없도록 구성되어 클라이언트가 재로그인을 요구한다.
이와 함께 Apache는 외부 HTTPS 요청을 내부의 FastAPI 서비스로 전달하고, FastAPI는 다시 로컬 Ollama에 요청을 넘긴다. Ollama와 uvicorn은 외부에 직접 노출하는 대신 로컬 포트를 중심으로 연결하는 구조다. systemd가 백엔드 프로세스를 관리해 장애 발생 시 자동 재시작하도록 구성했다.
ATPIA가 얻은 것은 ‘모델 설치’가 아니라 ‘AI 서비스 운영 경험’
오픈소스 LLM의 장점은 모델 파일을 내려받을 수 있다는 데서 끝나지 않는다. 실제 서비스를 만들려면 GPU 메모리와 모델 크기, 추론 런타임, 비동기 통신, 스트리밍, 웹 UI, 인증, SSL, 리버스 프록시, 장애 복구 등 여러 층의 기술이 맞물려야 한다. 이번 Qwen3 프로젝트는 이 전 과정을 하나의 작동하는 서비스로 연결했다는 데 의미가 있다.
특히 Qwen3 서비스를 통해 ATPIA는 향후 기업·기관의 요구에 맞춘 로컬 AI 구축, 오픈소스 모델 연동, 사내 웹서비스화, 접근제어 및 운영 자동화 등으로 확장 가능한 기술 기반을 직접 검증했다. 다만 이번 개발보고서는 별도의 처리속도·동시접속자 수·정확도 벤치마크를 제시하지 않으므로, 현재 단계의 의미는 상용 성능을 과장하기보다 “자체 서버에서 실제 운영 가능한 엔드투엔드 LLM 서비스 기반을 구축했다”는 데 두는 것이 적절하다.
다음 단계: 14B 선택·세션 관리·이미지 입력까지
개발보고서에 제시된 후속 과제도 구체적이다. Qwen3 8B와 14B 모델을 UI에서 선택하는 기능, 사용자별 서버 사이드 대화 세션 관리, GPU 과부하를 방지하는 요청 제한(rate limiting), 시스템 프롬프트 설정, 대화 TXT/Markdown 내보내기, 그리고 이미지 입력을 지원하는 qwen3-vl:8b 연동 등이 계획돼 있다.
이 기능들이 순차적으로 적용되면 현재의 텍스트 채팅 중심 서비스에서 멀티모달·업무형 로컬 AI 플랫폼으로 발전할 수 있다. ATPIA는 제한 공개 단계에서 실제 사용성을 확인하면서 운영 경험을 축적하고, 이를 향후 AI 솔루션 개발과 로컬 AI 구축 기술로 이어갈 계획이다.
Qwen3 로컬 LLM 서비스 제한 공개 안내 이용 문의: contact@atpia.com 현재는 서버 자원과 운영 안정성을 고려해 문의한 제한 사용자에게만 접근 정보를 제공한다. |
※