
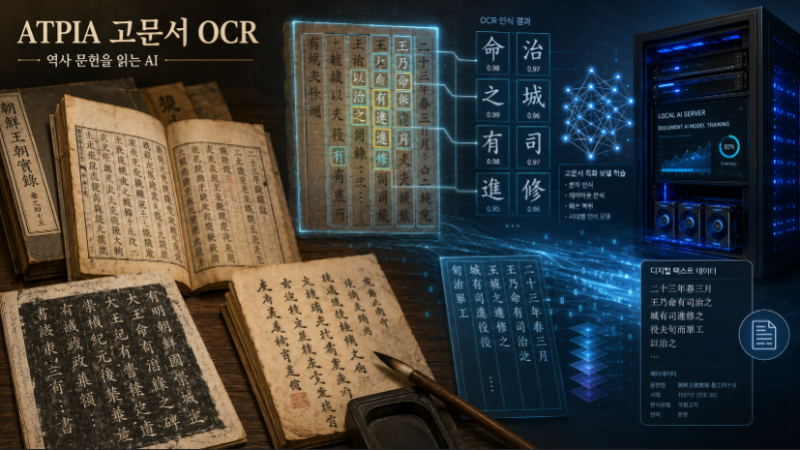
행서·석인본 중심으로 인식 파이프라인 고도화… AI-Hub 5만1,118쪽에서 54만여 열·858만여 자형 코퍼스 구축 — 중국·일본·대만의 공공 디지털고전 사업이 다루는 난제에 독립 개발팀으로 도전, GPU·R&D 지원이 다음 확장의 핵심
입력 2026.08.30 | ATPIA NEWS
주식회사 에트피아(ATPIA)가 조선시대 고서와 필사 고문서를 AI로 판독하는 고문서 OCR 프로젝트를 장기 연구과제로 진행하고 있다. 현재는 공개 OCR 서비스를 여는 단계가 아니라, 행서와 석인본 계열 문헌을 중심으로 제한된 Research Beta를 검증하기 위한 기술·운영 기반을 다지는 단계다. 이미 AI-Hub 고서 한자 인식 OCR 데이터셋을 바탕으로 대규모 학습 코퍼스와 GPU 추론 파이프라인을 구축했고, 실제 고문서 이미지의 업로드·인식·검수·교정·내보내기까지 이어지는 내부 워크플로도 검증했다. |
‘연구 아이디어’ 단계를 넘어, 실제 OCR 시스템의 형태가 잡혔다
ATPIA의 고문서 OCR 연구는 단일 모델 하나의 정확도 경쟁에 머물지 않는다. 고문서 한 페이지에서 세로쓰기 열을 찾고, 각 열에서 글자 위치를 찾아내고, 개별 자형을 인식한 뒤, 확신도가 낮거나 위험도가 높은 결과는 사람의 검토로 넘기는 전체 파이프라인을 설계해 왔다.
현재 핵심 후보 구조는 DBNet 기반 열 검출, 기하학적 열 순서 정렬, stride-4 heatmap 기반 글자 위치 추정, Stage2B ResNet18 계열 인식기, Top-K 후보 제시, Selective Risk 기반 검토 분기로 이어진다. Faster R-CNN, CRNN/CTC, Transformer 등 여러 구조도 직접 학습·비교했으며, 일반화가 약한 후보는 과감히 중단하고 성능이 확인된 구성요소만 남기는 방식으로 아키텍처를 좁혀 왔다.
이 과정의 의미는 ‘실패한 모델도 기록한다’는 데 있다. 예를 들어 Faster R-CNN은 소형 문자 일반화 성능이 부족해 중단 후보로 동결했고, Transformer 계열도 대규모 확장에서 뚜렷한 일반화 개선을 보이지 못한 실험은 확대하지 않았다. 반대로 DBNet 열 검출과 heatmap localizer, 20k 규모 인식기 부분 미세조정은 후속 파이프라인의 유효한 구성요소로 남았다.
숫자로 보는 현재 연구 기반
항목 | 규모 | 의미 |
|---|---|---|
AI-Hub 원본 페이지 | 50,118쪽 | 고서 한자 인식 OCR 데이터 기반 |
Column corpus | 542,453열 | 문헌 단위 누수 점검 후 재구성 |
Glyph 규모 | 8,583,049자형 | 학습·평가용 자형 단위 데이터 |
Unique character | 14,648자 | Column corpus 기준 |
Strict validation | 11,220열 / 8문헌 | 문헌 overlap 0, 현재 행서·석인본 중심 |
Full source hash audit | 50,118/50,118 | 약 87.57GiB 이미지 감사, 오류 0 |
행서·석인본에서 확인된 진척 — 그러나 ‘전체 고문서 인식 성공’은 아니다
보고서에서 가장 중요한 전제는 현재의 엄격한 holdout이 주로 행서와 석인본으로 구성돼 있다는 점이다. 따라서 현재 수치를 전서·초서·목판본·필사본 전체에 일반화된 성능으로 해석해서는 안 된다. ATPIA는 이 한계를 명시적으로 남기고, 지원 범위를 넓히기 전 독립 문헌과 다양한 서체·판본을 확보하는 절차를 선행하고 있다.
현재 동결 후보는 20쪽 공식 benchmark에서 자동 Page CER 0.49247을 기록했고, 별도의 100쪽 진단에서는 평균 CER 0.42712, P95 0.65730을 기록했다. 위험도가 낮은 90% 페이지만 선택적으로 받아들이는 실험에서는 평균 CER 0.37476을 보였으며, 해당 진단 세트에서 CER 1.0을 넘는 페이지를 모두 검토 대상으로 격리했다. 다만 이 결과 역시 현재 행서·석인본 중심의 제한된 검증 범위 안에서만 의미가 있다.
내부 GPU runner는 RTX 3060 환경에서 실제 이미지 처리와 API E2E를 검증했다. 한 차례의 실이미지 시험에서 1페이지를 78개 열, 73개 글자로 처리했고, full GPU 경로에서 약 8초대 결과가 확인됐다. 176회 soak test는 176회 모두 성공했고, 별도 staging 반복 시험도 30/30을 통과했다. 그러나 현재 공개 홈페이지는 연구 소개용이며 일반 사용자의 OCR 업로드 기능은 열지 않았다. staging worker도 검증 뒤 안전하게 정지·비활성화한 상태다.
데이터 누수까지 다시 감사했다 — ‘잘 나온 숫자’보다 독립 평가가 먼저
고문서 OCR에서 가장 위험한 오류 가운데 하나는 같은 문헌의 페이지가 학습과 검증에 동시에 섞이는 데이터 누수다. ATPIA는 원본 360개 문헌의 split을 다시 감사하면서 upstream validation 191개 문헌 가운데 183개가 train의 동일 document_id와 겹친다는 사실을 확인했다. 이를 그대로 성능 근거로 사용하지 않고, 학습에 사용한 352문헌과 strict-core 8문헌으로 다시 잠갔다.
또한 50,118개 원본 이미지 전체에 대해 content·pixel·perceptual hash 감사를 수행했다. 교차 split의 exact duplicate는 확인되지 않았으며, 향후 일반화 성능을 주장하려면 기존 AI-Hub corpus와 다른 독립 문헌이 필요하다는 결론을 내렸다. 국립중앙도서관·국사편찬위원회·장서각·규장각·국가유산포털·한국고전종합DB 등의 자료는 AI 평가·GT 가공·파생 annotation·보관·자동 접근의 이용 조건을 별도 확인해야 하므로, 허가 전에는 연구 corpus에 섞지 않는 fail-closed 정책을 유지하고 있다.
중국·일본·대만은 이미 국가·공공기관 단위로 ‘디지털 고전’을 구축 중
동아시아의 고문헌 디지털화는 이미 국가도서관·국가 연구기관 단위의 장기 사업으로 진행되고 있다. 중국 국가도서관은 국가 스마트도서관 체계의 일부로 ‘중화고적 지능화 서비스 플랫폼’을 운영하며 1만 종이 넘는 고적 자원을 통합하고, 자동 OCR·번역·지식추출·판본 비교와 AI 도우미를 결합하고 있다.
일본 국립국회도서관(NDL)은 2021년도 OCR 텍스트 변환 사업에서 약 247만 점의 디지털 자료를 OCR로 텍스트화하는 대규모 사업을 실시했다. Next Digital Library에서는 약 35만 점의 공개 자료를 대상으로 검색 실험을 제공하고, 이 가운데 고전 자료 약 6만 점에는 고전적 OCR 실험 결과를 활용하고 있다. 2026년에는 NDL 디지털 자료의 OCR 기반 전자 텍스트 제공 범위가 약 347만 점까지 확대됐다.
대만도 국가도서관과 중앙연구원 중심으로 장기간 디지털 고전 인프라를 축적해 왔다. 대만 국가도서관은 국제 협력을 통해 2022년 기준 4,700종, 약 320만 장의 고적 이미지를 디지털화했다고 밝혔고, 현재 특별장서 디지털 이미지 규모는 700만 장을 넘는다. 중앙연구원 사어소의 Scripta Sinica는 1984년부터 이어진 프로젝트로, 2019년 말 기준 1,000종이 넘는 문헌과 7억 자 이상의 텍스트를 축적했다.
공공 프로젝트와 ATPIA의 위치 — ‘같은 숫자’가 아니라 ‘같은 난제’를 비교해야
지역 | 대표 프로젝트 | 공개·연구 규모 예시 | 핵심 성격 |
|---|---|---|---|
중국 | 국가도서관 고적 지능화 플랫폼 | 1만 종+ 고적 자원 | OCR·번역·지식추출·AI 서비스 |
일본 | 국립국회도서관 OCR/Next Digital Library | 247만 점 OCR 사업, 고전 OCR 6만 점 등 | 대규모 전자화·검색·고전적 OCR |
대만 | 국가도서관·중앙연구원 | 수백만 이미지·수억 자 전자문헌 | 장기 디지털아카이브·전문 연구 DB |
ATPIA | Historical OCR R&D | 50,118쪽·54만 열·858만 자형 | 행서·석인본 중심 OCR 파이프라인·검수형 Research Beta |
물론 이 수치들은 직접적인 우열 비교가 아니다. 중국·일본·대만의 수치는 국가기관이 장기간 축적한 전체 디지털 장서·서비스 규모이고, ATPIA 수치는 특정 AI-Hub 기반 OCR 연구 corpus와 파이프라인 규모다. 절대적인 소장량과 서비스 범위는 국가 프로젝트가 훨씬 크다. 다만 독립 개발팀이 5만 쪽 원본을 문헌 단위로 다시 감사하고, 54만 열·858만 자형의 학습·평가 구조를 만들며, detector·localizer·recognizer·Top-K 검수·위험도 분기까지 한 체계로 묶었다는 점에서 기술 문제의 난도와 연구 범위는 국가기관형 프로젝트가 다루는 핵심 과제와 맞닿아 있다. ‘손색없는 규모’라는 평가는 전체 국가 사업과 동일하다는 뜻이 아니라, 독립 R&D 프로젝트로서의 데이터 처리 밀도와 기술 범위를 두고 하는 표현이 더 정확하다.
다음 벽은 알고리즘보다 ‘연산 자원·독립 자료·사람의 검수’다
ATPIA는 현재 NVIDIA RTX 3060 12GB 단일 GPU를 중심으로 학습과 검증을 수행하고 있다. 이 장비만으로도 여러 후보 구조를 학습하고 내부 Research Beta 파이프라인까지 만들었지만, 더 큰 모델과 더 많은 서체·판본을 반복 학습하고 다수의 실험을 병렬 비교하기에는 명확한 한계가 있다.
특히 다음 단계는 단순히 GPU 한 장을 더 추가하는 문제에 그치지 않는다. 기존 AI-Hub와 겹치지 않는 독립 문헌의 이용허락 확보, 전서·초서·목판본·필사본 등 다양한 자료의 정답(GT) 구축, 고문헌 전문가의 교정, 대용량 이미지 저장과 백업, 반복적인 모델 학습·회귀 시험, 연구 결과를 안정적인 웹서비스로 전환하는 엔지니어링 인력이 함께 필요하다.
ATPIA는 정부의 GPU 인프라 지원과 AI 연구개발 자금이 확보될 경우, 현재 행서·석인본 중심의 제한된 검증을 넘어 다서체·다판본 독립 평가, 대규모 재학습, 전문가 교정 데이터 구축, Research Beta의 안정적 운영으로 개발 속도를 크게 높일 수 있다고 보고 있다. 해외의 국가도서관·공공 연구기관이 장기간 예산과 인프라를 투입해 디지털 고전을 구축해 온 것과 비교하면, 국내에서도 고문헌 AI를 문화유산 디지털화와 AI 원천기술의 교차 분야로 보고 지속적인 공공 지원 체계를 마련할 필요가 있다. |
한자자전과 연결되면 ‘읽는 OCR’에서 ‘해석하는 AI’로
ATPIA가 고문서 OCR을 장기 과제로 보는 이유는 단순 문자 판독률만 높이는 데 있지 않다. 이미 운영 중인 ATPIA 한자자전은 10만 자가 넘는 문자 원장과 간체·번체·이체자 관계, 한국·중국·일본 독음과 뜻, 획순, 서체·서예, 고대 자형, 수십만 건의 한자어·용례 데이터를 연결하고 있다.
향후 OCR이 인식한 후보 문자를 이 한자자전의 이체자·고대 자형·독음·뜻·용례와 연결하면, 고문서의 글자를 단순히 Unicode 문자로 바꾸는 것을 넘어 ‘왜 이 글자로 보이는가’, ‘다른 판본에서는 어떤 자형인가’, ‘당시 문맥에서 어떤 뜻인가’를 연구자가 검증할 수 있는 Document AI 플랫폼으로 확장할 수 있다. ATPIA가 국내외 OCR·컴퓨터비전 연구성과를 하나의 서비스 구조로 집대성하려는 이유도 여기에 있다.
공개 베타보다 먼저 해야 할 일 — 정확히 모르는 것을 ‘모른다’고 표시하는 기술
현재 historical-ocr.atpia.com은 기술 소개용 공개 홈페이지다. 일반 사용자의 OCR 업로드와 공개 실행은 아직 제공하지 않는다. ATPIA는 독립 평가자료와 이용허락, 다양한 서체·판본의 일반화, 최종 아키텍처가 충분히 검증되기 전에 공개 베타를 서두르지 않는다는 방침이다.
고문서 OCR은 현대 인쇄체보다 훨씬 어렵다. 같은 글자도 시대·필체·판본에 따라 형태가 달라지고, 훼손·먹 번짐·세로쓰기·주석·도장·판심과 같은 요소가 인식을 방해한다. 그렇기 때문에 높은 숫자 하나보다 틀릴 가능성이 큰 페이지를 찾아 사람에게 돌려주는 기능, 원본과 AI 예측과 사람의 교정 결과를 구분해 보존하는 기능이 중요하다.
5만여 쪽의 원본, 54만여 개의 세로 열, 858만여 자형을 다루는 현재의 연구는 시작에 가깝다. 그러나 작은 개발팀이 자체 GPU 서버와 공개 데이터로 여기까지 구축한 것은 국내 고문헌 AI의 가능성을 보여주는 하나의 사례다. 이제 필요한 것은 더 넓고 독립적인 검증자료, 더 많은 계산 자원, 그리고 장기 연구를 이어갈 수 있는 개발 자금이다.
프로젝트 안내
항목 | 내용 |
|---|---|
프로젝트 | ATPIA Historical OCR / 고문서 OCR |
공개 소개 | https://historical-ocr.atpia.com |
현재 단계 | 행서·석인본 중심 Research Beta 준비·검증 / Public Beta 미오픈 |
연구 기반 | AI-Hub 고서 한자 인식 OCR 데이터셋, RTX 3060 12GB GPU |
핵심 기술 | DBNet Column Detector · Heatmap Glyph Localizer · ResNet18 Recognizer · Top-K · Selective Risk |
기사 작성 참고자료
• 주식회사 에트피아, 「고문서 OCR 최종개발 보고서」(2026.08.30 기준 및 보고서 내 단계별 검증 기록)
• AI-Hub, 고서 한자 인식 OCR 데이터(dataset 603) — 원본 제공 조건과 attribution 우선
• National Library of China, “The Intelligent Service Platform for Chinese Ancient Books is launched for trial operation” (2025.05.20)
• National Diet Library, Japan, “OCR text conversion of digitized materials in FY2021” 및 Next Digital Library / Mina Search
• National Central Library, Taiwan, ancient Chinese books digitization project 및 Rare Books & Special Collections Resource System
• Academia Sinica, Institute of History and Philology, Scripta Sinica Project / Scripta Sinica Research Group